El comité de dirección recibe un informe aparentemente excelente. La empresa genera contenido en doce idiomas. El coste unitario ha bajado. Una campaña que antes tardaba tres semanas ahora puede estar lista en tres horas. El número de usuarios de la herramienta crece cada mes.
Todo parece perfecto.
Hasta que alguien formula la única pregunta que importa:
¿Qué resultado empresarial nos ha dado todo esto?
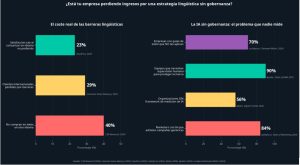
En muchas organizaciones, la respuesta no está en el informe. No porque falten datos, sino porque se están midiendo las variables que demuestran que la IA se utiliza, no las que demuestran que la inversión funciona.
Se suele pasar por alto algo tan importante cuando hablamos de la adopción corporativa de IA. Las empresas han comprado licencias, conectado plataformas, formado equipos y anunciado transformaciones. Cuestionar ahora el retorno puede resultar incómodo. Sin embargo, seguir midiendo actividad como si fuera valor no protege la inversión: impide corregirla.
La paradoja: casi todos usan IA, pocos pueden vincularla al resultado financiero
La encuesta global de McKinsey de 2025 muestra hasta qué punto se han separado adopción y valor. El 88 % de los participantes afirmó que su organización utilizaba IA regularmente en al menos una función. Sin embargo, solo el 39 % declaró algún impacto de la IA en el EBIT de toda la empresa y, entre quienes sí reportaron impacto, la mayoría lo situó por debajo del 5 % del EBIT [1].
BCG añade una segunda parte a la paradoja. Las empresas preveían duplicar su gasto en IA durante 2026, pasando aproximadamente del 0,8 % al 1,7 % de sus ingresos. Más del 90 % esperaba mantener o aumentar la inversión aunque no obtuviera retorno durante el año siguiente [2].
La empresa todavía no ha demostrado el retorno, pero ya ha decidido seguir gastando.
Esto no demuestra que la IA no funcione. Demuestra algo más útil: usar una tecnología, producir más rápido y generar valor financiero son tres cosas distintas.
| Nivel | Pregunta que responde | Ejemplos de indicadores |
| Adopción | ¿Se está utilizando la IA? | Usuarios activos, prompts, palabras procesadas, idiomas cubiertos |
| Productividad | ¿Se ejecuta una tarea más rápido? | Minutos de generación, tiempo de traducción, documentos por hora |
| Impacto empresarial | ¿Ha mejorado el resultado de la organización? | Coste total, margen, conversión, tiempo hasta el mercado, incidencias, retención, riesgo |
Un flujo puede obtener una puntuación excelente en las dos primeras filas y no traducirse en ningún cambio en la tercera. También puede empeorarla.
Por qué resulta tan difícil hacer la pregunta incómoda
Toda gran implantación crea incentivos internos. Hay un patrocinador ejecutivo, un presupuesto aprobado, objetivos anunciados y expectativas que gestionar. Cuanto mayor es la inversión y más visible fue la decisión, más difícil resulta concluir que el proyecto necesita reducirse, rediseñarse o detenerse.
La economía conductual denomina falacia del coste hundido a la tendencia a seguir invirtiendo en una decisión debido a los recursos ya comprometidos, aunque esos recursos no puedan recuperarse. En una organización, el fenómeno no suele presentarse como una negativa explícita a medir. Aparece de una forma más sutil: se eligen indicadores que hacen que la implantación parezca avanzar.
BCG observó que la mitad de los CEO encuestados consideraba que su puesto podía estar en juego si la IA no daba resultados. El mismo estudio encontró una brecha de confianza: el 62 % de los CEO confiaba en el retorno, frente al 48 % de los responsables no tecnológicos que estaban lejos de la alta dirección [2]. Estos datos no prueban que nadie esté ocultando resultados. Sí muestran que quien decide la inversión y quien experimenta el funcionamiento diario pueden estar evaluando realidades diferentes.
De ahí nace una práctica muy común: sustituir una pregunta difícil por otra fácil.
En lugar de preguntar «¿ha aumentado la conversión en Alemania?», se pregunta «¿cuántas páginas hemos generado en alemán?». En lugar de medir «¿ha disminuido el coste total hasta publicación?», se comunica «¿cuánto ha bajado el coste por palabra?». En lugar de comprobar «¿qué porcentaje supera el control a la primera?», se celebra «¿cuánto tarda el modelo en producir un borrador?».
La métrica es real. La conclusión no siempre lo es.
Traducir más rápido no es ROI
La frase más frecuente en un análisis de viabilidad de IA lingüística es también una de las más engañosas:
«Antes tardábamos tres semanas. Ahora tardamos tres horas».
La mejora puede ser valiosa, pero todavía no es un retorno. Para convertir el tiempo ahorrado en valor hay que demostrar qué ocurrió después. ¿Se lanzó el producto antes? ¿Se publicó más contenido útil? ¿El equipo empleó la capacidad liberada en trabajo de mayor valor? ¿Se redujo realmente el coste laboral o simplemente se desplazó el esfuerzo a la revisión, la coordinación y las correcciones?
IBM señala que alrededor del 79 % de los ejecutivos percibe ganancias de productividad derivadas de la IA, pero solo aproximadamente el 29 % afirma poder medir su ROI con confianza [3]. La distancia entre ambas cifras resume bien el problema: una mejora operativa potencial no se convierte automáticamente en un resultado financiero.
En los flujos multilingües, la ilusión es especialmente fácil de crear porque la generación es casi instantánea y muy visible. Los costes posteriores, en cambio, están repartidos entre equipos: Marketing corrige el tono, Producto detecta cadenas que no encajan, Legal revisa afirmaciones, Soporte responde dudas que el contenido no resolvió y el responsable local rehace mensajes que no funcionan en su mercado.
La máquina terminó en tres horas. La empresa quizá no terminó nunca.
La métrica que falta: coste por activo publicable
Durante años, el coste por palabra fue la medida dominante de la traducción. En un entorno LangOps, esa cifra resulta insuficiente. Puede describir el precio de una fase, pero no el coste de obtener un resultado utilizable.
La unidad que interesa al negocio es el coste por activo publicable: cuánto cuesta producir una página, campaña, manual, interfaz o comunicación que pueda salir al mercado, cumpla su función y no genere una deuda posterior desproporcionada.
Ese coste debe incluir, como mínimo, la licencia o consumo del modelo, las plataformas auxiliares, la integración, la preparación de datos, la gestión del flujo, la revisión humana, las correcciones, las repeticiones, las incidencias y el mantenimiento. Cuando así se requiera, también debe incorporar una estimación del riesgo y del coste de oportunidad.
Una forma sencilla de expresarlo es:
Coste del activo publicable = generación + tecnología + integración + gestión + revisión + corrección + incidencias + mantenimiento
Esta perspectiva cambia la conversación. Un flujo que reduce un 80 % el coste de generación puede ser peor negocio si triplica el tiempo de revisión, aumenta los errores críticos o produce contenido que no convierte. Del mismo modo, un flujo con una revisión humana aparentemente costosa puede generar un retorno mayor si reduce el retrabajo, acelera la aprobación regulatoria o protege una campaña de alto valor.
RWS identifica otro obstáculo: la información necesaria para calcular este retorno suele estar fragmentada. Marketing controla la interacción y la conversión; Producto, las fechas de lanzamiento; Compliance, las incidencias; Finanzas, las facturas; y el equipo lingüístico, el volumen y la calidad. Cada conjunto de datos cuenta una parte de la historia, pero ninguno demuestra el valor por sí solo [5].
Medir el ROI de LangOps no consiste, por tanto, en añadir otra herramienta al flujo. Consiste en conectar datos que la empresa ya tiene, pero mantiene separados.
Las métricas que pueden maquillar el fracaso
Ninguna de las métricas tradicionales es inútil. El error es interpretarlas fuera de contexto.
| Métrica habitual | Lo que demuestra | Lo que no demuestra |
| Coste por palabra | Precio unitario de una fase | Coste total del contenido utilizable |
| Palabras o activos por hora | Velocidad bruta | Calidad, relevancia o rendimiento comercial |
| Número de idiomas | Cobertura teórica | Presencia efectiva o adecuación a cada mercado |
| Tiempo de generación | Duración de la producción inicial | Tiempo total hasta aprobación y publicación |
| Usuarios activos | Adopción interna | Valor económico generado |
| Horas ahorradas | Capacidad potencial liberada | Cómo se utilizó esa capacidad |
| Puntuación lingüística aislada | Corrección respecto a un criterio | Si el contenido cumple su objetivo empresarial |
Incluso una métrica aparentemente avanzada puede inducir a error si se utiliza sola. El Time to Edit, por ejemplo, mide cuánto tarda una persona en llevar un resultado automático al nivel requerido y puede ser un buen indicador de eficiencia del sistema [6]. Pero un texto que necesita poca edición puede seguir sin posicionar, no convertir o resultar inadecuado para la función regulatoria que debe cumplir.
La medición útil combina proceso, resultado y riesgo.
El cuadro de mando LangOps que debería ver la dirección
No todas las empresas necesitan el mismo panel, pero cualquier implantación de IA multilingüe debería poder responder a ocho preguntas.
| Dimensión | Indicador recomendado | Pregunta para la dirección |
| Coste | Coste total por activo publicable | ¿Cuánto cuesta realmente obtener contenido utilizable? |
| Eficiencia | Tiempo total desde la solicitud hasta la publicación | ¿Se acelera el negocio o solo una fase? |
| Trabajo humano | Minutos de revisión por activo o por 1.000 palabras | ¿La IA elimina esfuerzo o lo desplaza? |
| Calidad | Tasa y gravedad de errores; first-pass yield | ¿Qué porcentaje supera el control a la primera? |
| Mercado | Conversión, interacción, visibilidad o uso por mercado | ¿El contenido cumple la función para la que se creó? |
| Cliente | Tickets, reclamaciones o abandonos atribuibles al idioma | ¿La automatización genera fricción posterior? |
| Riesgo | Incidentes de compliance, privacidad o marca | ¿Qué exposición crea o evita el flujo? |
| Aprendizaje | Repetición de correcciones y evolución del rendimiento | ¿El sistema mejora o reproduce los mismos fallos? |
El first-pass yield —el porcentaje de activos que supera el control a la primera— merece atención especial. Una empresa puede producir diez veces más contenido con IA y, al mismo tiempo, saturar a sus revisores si casi ningún activo llega ya listo para publicarse. En ese caso, la capacidad de generación ha aumentado, pero la capacidad real de publicación no.
También conviene separar las métricas por tipo de contenido y nivel de riesgo. No tiene sentido evaluar con el mismo umbral una descripción de producto de bajo impacto, una campaña que define la voz de marca, unas instrucciones de seguridad o un documento regulatorio. La eficiencia aparece cuando el control es proporcional al riesgo, no cuando se aplica el mismo flujo a todo.
La cifra del 95 %: útil como advertencia, peligrosa como eslogan
El informe preliminar The GenAI Divide, elaborado por MIT Project NANDA en 2025, afirmó que el 95 % de las organizaciones estudiadas no estaba obteniendo retorno medible de sus iniciativas de IA generativa y que solo el 5 % de determinadas herramientas empresariales llegaba con éxito a producción [4]. Es una cifra impactante y se ha repetido ampliamente.
También requiere contexto. El informe se basa en una revisión de más de 300 iniciativas públicas, entrevistas con 52 organizaciones y una encuesta a 153 directivos. Los propios autores advierten de que algunos resultados son direccionales, las muestras varían por categoría y las definiciones de éxito no son homogéneas [4].
Por tanto, el 95 % no debería utilizarse como una tasa universal de fracaso de toda la IA corporativa. Su valor está en la explicación del patrón: los proyectos que no se integran en el trabajo real, no aprenden de las correcciones y no se evalúan por resultados de negocio tienden a quedarse en demostraciones o pilotos.
La lección para LangOps es clara: el modelo importa menos que el sistema en el que se inserta.
Cómo diseñar una prueba que pueda sobrevivir al CFO
Una prueba seria de ROI no necesita empezar con un gran programa de transformación. Puede construirse sobre un contenido, un mercado y una hipótesis verificable.
Primero, hay que definir el resultado antes de elegir la herramienta. «Usar IA para traducir la base de conocimiento» no es un objetivo. «Reducir un 20 % el tiempo hasta publicación sin aumentar las incidencias de soporte ni los errores críticos» sí lo es.
Después se establece la línea base del proceso actual: coste total, tiempo completo, esfuerzo humano, tasa de aprobación, incidencias y resultado de mercado. Sin esa fotografía inicial, cualquier mejora posterior será una mera opinión.
A continuación, se comparan dos flujos durante un periodo suficiente y con contenidos equivalentes. El cálculo debe incluir todos los costes, no solo los más fáciles de obtener. También debe establecerse por adelantado un criterio de decisión: qué resultado permitirá escalar, cuál obligará a rediseñar y cuál justificará detener la prueba.
| Paso | Decisión necesaria | Error que evita |
| 1. Elegir caso y mercado | ¿Qué resultado empresarial buscamos? | Implantar tecnología sin objetivo |
| 2. Fijar línea base | ¿Cómo funciona y cuánto cuesta hoy? | Declarar mejoras sin comparación |
| 3. Diseñar comparación | ¿Qué dos flujos evaluamos y durante cuánto tiempo? | Confundir casos distintos |
| 4. Incluir coste total | ¿Qué trabajo y riesgo aparecen después de generar? | Inflar el ahorro aparente |
| 5. Medir el resultado | ¿Qué ocurrió en publicación, cliente y mercado? | Quedarse en métricas de actividad |
| 6. Aplicar criterio de salida | ¿Escalamos, rediseñamos o detenemos? | Convertir una prueba en adopción obligatoria |
El último paso es el más importante. Una implantación sin criterio de salida no es un experimento: es una decisión tomada de antemano.
Medir primero, rediseñar después
Aquí es donde LangImpact se diferencia de un proveedor que simplemente vende más capacidad de traducción.
LangScore permite establecer una línea base y auditar el resultado del contenido multilingüe. Convierte impresiones como «parece correcto» o «suena bastante bien» en una evaluación estructurada de consistencia, terminología, voz, adecuación y riesgo. Esa medición no constituye por sí sola el ROI, pero proporciona la evidencia necesaria para calcular el coste de obtener un activo utilizable y detectar dónde se está perdiendo valor.
LangFlow actúa sobre lo que la medición revela. Rediseña el flujo para decidir qué debe automatizarse, qué contexto necesita la IA, dónde debe intervenir una persona, qué reglas se aplican por tipo de contenido y cómo se devuelve el aprendizaje al sistema. El objetivo no es añadir revisión humana a todo, sino utilizarla donde el riesgo y el valor lo justifiquen.
El orden importa: primero se mide; después se rediseña. Así, la empresa no tiene que abandonar la inversión en IA ni defenderla por fe. Puede recuperar lo que funciona, corregir lo que destruye valor y detener lo que no tiene sentido.
La pregunta que debería cerrar la próxima reunión
El verdadero retorno de una estrategia multilingüe con IA no se expresa en palabras generadas ni en segundos ahorrados. Se expresa en activos publicables, mercados atendidos, clientes convertidos, incidencias evitadas y riesgos controlados.
La próxima vez que un informe anuncie que la IA ha multiplicado la producción y reducido el coste unitario, conviene formular tres preguntas:
¿Cuánto cuesta obtener un activo realmente publicable? ¿Qué resultado genera? ¿Qué riesgo añade?
Si el cuadro de mando no puede responderlas, la organización no está midiendo el retorno de su IA.
Está midiendo su actividad.
Referencias
[1] McKinsey (2025). The State of AI in 2025: Agents, Innovation, and Transformation. https://www.mckinsey.com/capabilities/quantumblack/our-insights/the-state-of-ai-2025
[2] Boston Consulting Group (2026). As AI Investments Surge, CEOs Take the Lead — BCG AI Radar 2026. https://www.bcg.com/publications/2026/as-ai-investments-surge-ceos-take-the-lead
[3] IBM (2026). How to Maximize AI ROI in 2026. https://www.ibm.com/think/insights/ai-roi
[4] MIT Project NANDA (2025). The GenAI Divide: State of AI in Business 2025. https://mlq.ai/media/quarterly_decks/v0.1_State_of_AI_in_Business_2025_Report.pdf
[5] RWS (2025). How to Measure Localization ROI in Enterprise Programs. https://www.rws.com/blog/how-to-measure-localization-roi-in-enterprise-programs/
[6] Translated. The ROI of AI Translation: Measuring Business Impact. https://translated.com/resources/the-roi-of-ai-translation-measuring-business-impact